
はじめに
前回は、Vite を組み込みの言葉で読み解きました。今回は、Step 1 の単位換算ツールで実際に書いた TypeScript のコードを、C と並べながら読んでいきます。
JavaScript すら書いたことがない状態から始めましたが、計算の部分に限って言えば、C と大きくは変わらないと感じています。一方で、書き方の見た目が違うものや、C にはない便利な仕組みもありました。
この回で取り上げるのは、次の4つです。
- 構造体、enum、const のテーブルにあたる書き方
- 配列の検索と、関数を渡す書き方
- import と export(C のヘッダにあたるもの)
- タグ付き共用体を使った、入力チェックの結果の返し方
その前に、TypeScript を C のコンパイラのように厳しく働かせる設定から紹介します。
型チェックを厳しくする
前回紹介したとおり、Vite は TypeScript を JavaScript に変換してくれますが、型の誤りは検査しません。変換を速くするために、型の情報を読み飛ばしているからです。
そこで、型の検査だけを TypeScript のコンパイラ(tsc)に任せることにしました。C でいえば、コンパイラの警告を -Wall -Werror で厳しくしておくのに近い役割です。
設定ファイル
ブラウザ用のコードを検査する設定は、次のとおりです。
{
  "compilerOptions": {
    "target": "ES2022",
    "module": "ESNext",
    "moduleResolution": "bundler",
    "lib": ["ES2022", "DOM"],
    "strict": true,
    "noEmit": true
  },
  "include": ["src/main.ts", "src/conv.ts"]
}| 設定 | 意味 |
|---|---|
lib: ["DOM"] | ブラウザの画面の部品(document など)を使うと宣言する |
strict: true | 厳しく検査する。警告をすべて有効にするイメージ |
noEmit: true | 検査だけ行い、ファイルは出力しない(出力は Vite の担当) |
include | 検査の対象。ブラウザ用の2つのファイルだけ |
検査用のコマンドを登録して、実行します。
$ npm pkg set scripts.check="tsc -p tsconfig.json"
$ npm run check何も表示されずに終われば合格です。C のコンパイルと同じく、何も言われないのが一番よい結果です。
わざと間違えてみる
型チェックのありがたみは、わざと間違えるとよくわかります。後で紹介する換算の関数では、換算の向きを 'toSi' か 'fromSi' のどちらかで指定します。これを、大文字の I にした 'toSI' と書き間違えて npm run check を実行すると、次のようなエラーになります(行番号などは例です)。
src/main.ts:8:31 - error TS2345: Argument of type '"toSI"' is not assignable to parameter of type 'Direction'.「'toSI' は Direction という型には入れられない」という意味です。JavaScript では、この誤字に気づかずに実行され、条件分岐の結果として黙って逆向きの計算をしてしまいます。TypeScript なら、実行する前に見つけられます。
構造体・enum・const テーブル:conv.ts を C と並べる
換算の計算は、conv.ts というファイルにまとめました。第3回で紹介した設計書の換算テーブルを、そのままコードにしたものです。
// 検査項目の id と換算の向き(C の enum に相当)
export type ItemId = 'glucose' | 'tchol' | 'tg' | 'cre';
export type Direction = 'toSi' | 'fromSi';

// 検査項目1件分の情報(C の struct に相当)
export interface Item {
  id: ItemId;
  name: string;      // 表示名
  convUnit: string;  // 従来単位
  siUnit: string;    // SI 単位
  factor: number;    // SI = mg/dL × factor
}

// 換算テーブル(C の const 構造体配列に相当)
export const ITEMS: readonly Item[] = [
  { id: 'glucose', name: '血糖',             convUnit: 'mg/dL', siUnit: 'mmol/L', factor: 1 / 18.016 },
  { id: 'tchol',   name: '総コレステロール', convUnit: 'mg/dL', siUnit: 'mmol/L', factor: 1 / 38.67 },
  { id: 'tg',      name: '中性脂肪',         convUnit: 'mg/dL', siUnit: 'mmol/L', factor: 1 / 88.57 },
  { id: 'cre',     name: 'クレアチニン',     convUnit: 'mg/dL', siUnit: 'µmol/L', factor: 88.4 },
];同じものを C で書くと、おおよそ次のようになります。
typedef enum { GLUCOSE, TCHOL, TG, CRE } ItemId;
typedef enum { TO_SI, FROM_SI } Direction;

typedef struct {
    ItemId      id;
    const char *name;
    const char *convUnit;
    const char *siUnit;
    double      factor;
} Item;

static const Item ITEMS[] = {
    { GLUCOSE, "血糖",             "mg/dL", "mmol/L", 1.0 / 18.016 },
    { TCHOL,   "総コレステロール", "mg/dL", "mmol/L", 1.0 / 38.67 },
    { TG,      "中性脂肪",         "mg/dL", "mmol/L", 1.0 / 88.57 },
    { CRE,     "クレアチニン",     "mg/dL", "µmol/L", 88.4 },
};並べてみると、形はほとんど同じです。対応は次のとおりです。
| TypeScript | C で近いもの | 違い |
|---|---|---|
type ItemId = 'glucose' | … | enum | 値が数字ではなく文字列。決めた値以外を入れるとコンパイルエラー |
interface Item { … } | struct の型定義 | メンバの並び順やメモリ配置は気にしなくてよい |
readonly Item[] | const 配列 | 書き換えようとするとコンパイルエラー |
number | double | 整数と小数の区別がなく、数値はすべて同じ型 |
TypeScript の enum にあたるものが、文字列の並び('glucose' | 'tchol' | …)になっているのが面白いところです。この書き方をユニオン型と呼び、| は「どれか1つ」を表します。値がそのまま意味のある文字列なので、画面の選択肢の値(<option value="glucose">)とも、そのまま対応づけられます。
計算の関数
換算の関数は、C とほぼ同じ見た目です。
export function convert(value: number, item: Item, dir: Direction): number {
  return dir === 'toSi' ? value * item.factor : value / item.factor;
}

export function formatResult(v: number): string {
  return v.toFixed(2);   // 小数2桁の文字列にする(printf の %.2f)
}違うのは、型を名前の後ろに : number のように書く点です。C の double convert(double value, …) と、前後が入れ替わっています。また、=== は「型も値も等しいか」を調べる比較で、C の == に相当します。JavaScript の == は '1' == 1 が true になるような暗黙の型変換をしてしまうので、通常は === を使います。
計算部分だけで単体確認
この conv.ts は画面のことを一切知らないので、画面を作る前に、計算だけを確かめられます。100 mg/dL を各項目で換算し、ブラウザの開発者ツール(F12)のコンソールに表示させました。組み込みでいう、UART への printf デバッグです。
血糖: 100 mg/dL = 5.55 mmol/L
総コレステロール: 100 mg/dL = 2.59 mmol/L
中性脂肪: 100 mg/dL = 1.13 mmol/L
クレアチニン: 100 mg/dL = 8840.00 µmol/L4つとも手計算と一致しました。演算ライブラリを、ドライバより先に単体でテストするのと同じ進め方です。
配列の検索と、関数を渡す書き方
画面で選ばれた検査項目(たとえば 'tg')から、テーブルの該当する行を探す関数です。
export function findItem(id: string): Item | undefined {
  return ITEMS.find((it) => it.id === id);
}最初に見たとき、ITEMS.find((it) => it.id === id) の1行が何をしているのか、まったく読めませんでした。分解すると、次の3つの部品でできています。
| 部分 | 意味 |
|---|---|
ITEMS | 探す対象の配列 |
.find(…) | 配列に最初から付いている検索関数。先頭から順に③を呼び、true になった最初の要素を返す。最後まで見つからなければ undefined を返す |
(it) => it.id === id | 判定用の小さな関数(アロー関数)。it に要素が1つずつ渡され、id が一致するかを true / false で返す |
C で書くと
素直にループで書けば、次のとおりです(画面から文字列で届く id と比べるため、ここでは id を文字列で持つ構造体として書いています)。find は、このループを中に持っている関数です。
const Item *findItem(const char *id) {
    for (size_t i = 0; i < ITEMS_COUNT; i++) {
        if (strcmp(ITEMS[i].id, id) == 0) {
            return &ITEMS[i];   /* 見つかった */
        }
    }
    return NULL;                /* 見つからない */
}find と同じく「判定の関数を外から渡す」形にすると、標準ライブラリの qsort や bsearch に比較関数を渡すのと同じ形になります。
typedef bool (*MatchFunc)(const Item *it, const void *ctx);

const Item *find(const Item *arr, size_t n, MatchFunc match, const void *ctx) {
    for (size_t i = 0; i < n; i++) {
        if (match(&arr[i], ctx)) return &arr[i];
    }
    return NULL;
}

static bool matchId(const Item *it, const void *ctx) {
    return strcmp(it->id, (const char *)ctx) == 0;
}

const Item *p = find(ITEMS, ITEMS_COUNT, matchId, id); /* 呼び出し */C との大きな違い:外側の変数がそのまま見える
アロー関数の中の id は、アロー関数の引数ではありません。外側にある findItem(id: string) の引数です。
C では、判定関数から外側の変数が見えないので、void *ctx 経由で渡す必要がありました。TypeScript の関数は、自分が書かれた場所から見える変数を、そのまま使えます。これをクロージャと呼びます。void *ctx を自動で用意してくれる仕組み、と考えると、すんなり理解できました。
undefined は NULL
戻り値の型 Item | undefined は、「Item か、見つからなかったことを表す undefined のどちらか」という意味です。C の「構造体へのポインタ、または NULL」と同じです。
C との違いは、確かめずに使おうとすると、型チェックがエラーにしてくれることです。
const item = findItem(itemSel.value);
item.factor;           // エラー:undefined かもしれないので使えない

if (!item) return;     // 見つからなければここで終わる
item.factor; // OK:ここでは必ず Itemヌルポインタの参照を、実行する前に防いでくれるわけです。
import と export:ヘッダにあたるもの
画面の処理を書く main.ts の先頭には、次の1行があります。
import { findItem, convert, formatResult, type Direction } from './conv';「conv.ts が公開している部品のうち、この4つを main.ts で使います」という宣言です。
| 部分 | 意味 |
|---|---|
import | よそのファイルから部品を持ってくる |
{ … } | 持ってくる部品の名前の一覧 |
from './conv' | 持ってくる元のファイル。./ は同じフォルダ、拡張子 .ts は省略できる |
C のヘッダとの対応
C では、公開する関数や型をヘッダファイルに書き、#include して使いますね。TypeScript には、ヘッダファイルがありません。代わりに、ファイルの中で export を付けたものが、ヘッダに書いた公開部分になります。
| C | TypeScript |
|---|---|
| ヘッダに宣言を書く(extern) | ファイルの中で export を付ける |
static を付けて外から隠す | export を付けない |
#include "conv.h" | import { … } from './conv' |
| リンカが実体をつなぐ | Vite がビルドのときにつなぐ |
C の #include は、ヘッダの中身を丸ごと貼り付けます。TypeScript の import では、使うものを { } の中で名前を指定して持ってきます。名前を書き間違えたり、export していないものを書いたりすると、型チェックがエラーにしてくれます。C でいう「未定義の参照」のリンクエラーを、実行前に見つけてくれるイメージです。
type の付いたものは、実行時には消える
type Direction の type は、「これは型としてだけ使う」という目印です。import で取り込めるのは関数だけではなく、export されていれば定数も型も取り込めますが、目印が必要なのは型のときだけです。
| 取り込むもの | 例 | 目印 | ビルド後 |
|---|---|---|---|
| 関数 | findItem、convert | なし | 残る |
| 定数 | ITEMS | なし | 残る |
| 型 | Direction、Item | type | 消える |
型は TypeScript の検査のためだけに存在し、JavaScript に変換されると跡形もなく消えます。C の typedef や struct の型定義が、コンパイル後のバイナリに何も残らないのと同じです。
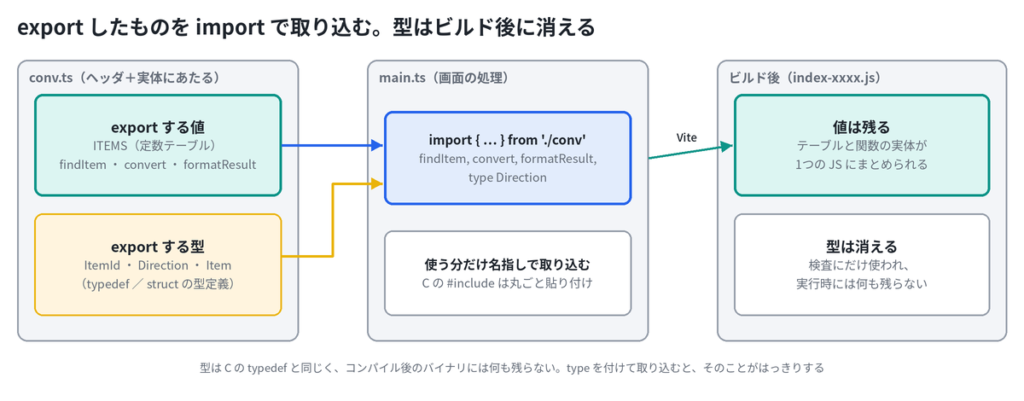
実は、今の設定では type を付けなくても動きます。Vite が型だと判断して取り除いてくれるからです。それでも付けるようにしているのは、読む人に「これは実行時には何もない」と伝えるためです。volatile のように、書かなくても動くことはあっても、意図を明示しておくと事故を防げる、という類のものだと考えています。
タグ付き共用体で、入力チェックの結果を返す
入力欄に -5 や abc が入ったときに、結果の代わりにメッセージを出す入力チェック(要件 F-05)を作りました。ここで、C のタグ付き共用体とまったく同じ考え方の書き方に出会いました。
成功なら数値、失敗ならメッセージ
チェックの結果を返す型を、次のように定義しました。
type ParseResult =
  | { ok: true; value: number }    // 成功の形
| { ok: false; error: string }; // 失敗の形「ok が true なら value を持ち、false なら error を持つ」という型です。ポイントは、ok の型が boolean ではなく true や false そのものになっていることです。TypeScript では、値そのものを型として使えます(リテラル型)。ok は、どちらの形かを見分けるためのタグとして働きます。
C で書くと、次のようになります。
typedef struct {
    bool ok;                 /* タグ */
    union {
        double value;        /* ok == true のときだけ有効 */
        const char *error;   /* ok == false のときだけ有効 */
    } u;
} ParseResult;組み込みでよく使う「戻り値でエラーコード、出力引数で値」という形(int parse(const char *s, double *out))を、1つの戻り値にまとめたもの、とも言えます。
関数の中身
チェックは、上から順に調べて、当てはまったところで結果を返します。
function parseInput(text: string): ParseResult {
  if (text === '') {
    return { ok: false, error: '値を入力してください' };
  }
  if (/^-\d+(\.\d+)?$/.test(text)) {
    return { ok: false, error: '0 以上の値を入力してください' };
  }
  if (!/^\d+(\.\d+)?$/.test(text)) {
    return { ok: false, error: '半角の数字で入力してください(例: 5.5)' };
  }
  return { ok: true, value: Number(text) };
}{ ok: false, error: '…' } は、その場で構造体の値を作る書き方で、C の複合リテラル (ParseResult){ .ok = false, .u.error = "…" } にあたります。
/^\d+(\.\d+)?$/ は正規表現と呼ばれる、文字列の形を調べるための記法です。
| 記号 | 意味 |
|---|---|
^ と $ | 文字列の先頭と末尾 |
\d+ | 数字(0〜9)が1文字以上 |
(\.\d+)? | 「小数点と数字1文字以上」が、あってもなくてもよい |
つまり「先頭から末尾まで、数字 または 数字.数字 の形だけ」です。受信したバイト列を、状態遷移で1文字ずつ照合するパーサーを1行で書けるようにしたもの、と考えると近いと思います。こうしておくと、100(全角)、1e3(指数表記)、0x10(16進数)のような、意図しない入力をまとめて弾けます。
呼び出す側:タグを確かめないと中身に触れない
入力欄の文字列は、前後の空白を trim() で削ってから渡します。コピー&ペーストで紛れ込んだ空白で、エラーにならないようにするためです。
const r = parseInput(valueInput.value.trim());
if (!r.ok) {
  result.textContent = '';
  message.textContent = r.error;   // 失敗の形だと確定しているので使える
  return;
}
message.textContent = '';
result.textContent = `${formatResult(convert(r.value, item, dir))} ${toUnit}`;   // 成功の形だと確定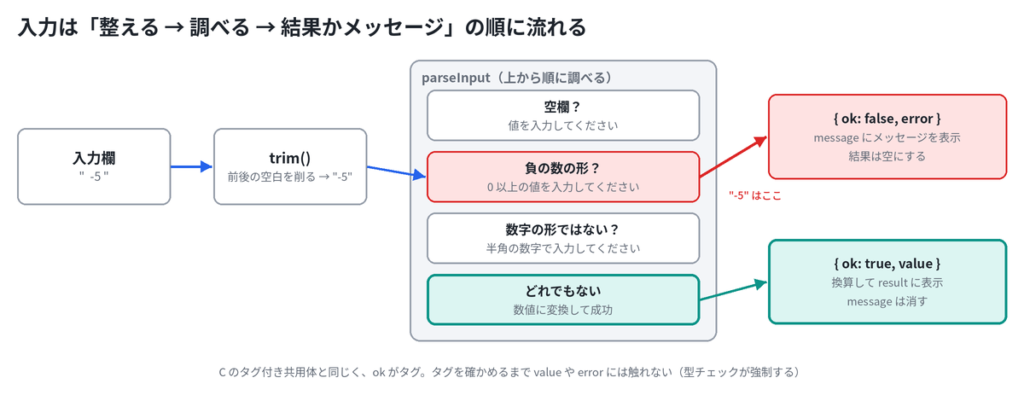
C の共用体では、タグを確かめずに r.u.value を読んでも、コンパイラは何も言いません。TypeScript では、if (!r.ok) { … return; } を通過するまで r.value に触れさせてくれません。通過した後は、「この先の r は成功の形だ」と判断してくれます。これを型の絞り込みと呼びます。
タグの確認漏れによる「失敗時のゴミ値を使ってしまう」バグを、実行前に防げるわけです。
まとめと次回予告
この回で出てきた TypeScript の書き方を、C と対応づけてまとめます。
| TypeScript | C でいうと |
|---|---|
interface / type | struct / typedef |
ユニオン型・リテラル型('toSi' | 'fromSi') | enum |
readonly 配列 | const 配列 |
Item | undefined | 構造体へのポインタ、または NULL |
{ ok: true; value } | { ok: false; error } | タグ付き共用体 |
export / import | ヘッダの公開宣言(extern)と #include |
| アロー関数とクロージャ | 関数ポインタ+コンテキスト(void *ctx) |
strict: true の型チェック | -Wall -Werror |
計算部分だけを見れば、C と大きく変わらないというのが正直な感想です。違いを感じたのは、TypeScript の型チェックが、C のコンパイラよりも一歩踏み込んで見張ってくれる点でした。NULL の確認漏れ、タグの確認漏れ、enum にない値の代入といった、C では実行してみるまで気づきにくい誤りを、実行前に指摘してくれます。
次回は、この関数たちを画面の操作とつなぐ部分を取り上げます。入力欄に1文字打つたびに計算が走る仕組みは、組み込みの割り込みとそっくりでした。
この記事は、シリーズ「組み込みエンジニアの Web 開発入門」の1本です。ほかの回は、シリーズの目次からどうぞ。




コメント