
【2026年10月24日時点の情報です】
第4回では、SELECT と WHERE で、表から条件に合う行を取り出したり、並べ替えたりしました。第5回は、取り出した行を数えたり、まとめて計算したりします。
ブログの管理では、「旧シリーズの記事が、公開中と削除済みで何件ずつあるか」を数えるコマンドを何度も使っていました。そのとき出てきた COUNT(*) や GROUP BY が、今回の主役です。
場面0:この回の前に知っておくこと
練習用のデータ
この回は、第3回で入れた6行の、最初の状態で試しています。値はすべて練習用の架空のものです。
| No. | measured_on | item_name | value_text | value_num | unit |
|---|---|---|---|---|---|
| 1 | 2026-09-01 | 血糖 | 98 | 98.000 | mg/dL |
| 2 | 2026-09-01 | CRP | 0.05 | 0.050 | mg/dL |
| 3 | 2026-09-01 | 尿蛋白 | (-) | NULL | NULL |
| 4 | 2026-10-01 | 血糖 | 104 | 104.000 | mg/dL |
| 5 | 2026-10-01 | CRP | 0.03未満 | 0.030 | mg/dL |
| 6 | 2026-10-01 | 尿蛋白 | (+-) | NULL | NULL |
No. は、表の id 列と同じ番号です。データを書き換えたり消したりしている場合は、第1回の付録の手順で、最初の状態に戻してから試してください。
MariaDB に入る
いつものように、練習用のユーザーで入ってから始めます。
mysql -u practice -p sql_practice以下の SQL は、すべて MariaDB の中(行頭が MariaDB [sql_practice]>)で打ちます。
NULL は「値がないもの」
尿蛋白の2行は、結果が「(-)」「(+-)」で数値にできないので、value_num が NULL(値がない)になっています。NULL は = で比べられず、IS NULL で調べる必要があります。今回の数える・まとめる計算でも、NULL は特別に扱われます。
場面1:行を数える(COUNT)
まずは、表に何行あるかを数えました。
SELECT COUNT(*) FROM measurements;
SELECT COUNT(value_num) FROM measurements;結果の例:
+----------+
| COUNT(*) |
+----------+
|        6 |
+----------+
1 row in set (0.002 sec)

+------------------+
| COUNT(value_num) |
+------------------+
|                4 |
+------------------+
1 row in set (0.000 sec)同じ表を数えているのに、6 と 4 で結果が違います。
- COUNT(*):
行の数。NULL があっても、すべての行を数える - COUNT(value_num):
value_num が NULL でない行の数。尿蛋白の2行は数えない
C で書くと、次のような違いです。
int count_all = 0, count_num = 0;
for (int i = 0; i < n; i++) {
    count_all++;                           /* COUNT(*) */
    if (rows[i].has_value_num) count_num++; /* COUNT(value_num) */
}「何件のデータがあるか」なら COUNT(*)、「グラフに描ける数値が何件あるか」なら COUNT(value_num)、と目的で使い分けます。
場面2:項目ごとに数える(GROUP BY)
次は、「項目ごとに何件あるか」を数えました。
SELECT item_name, COUNT(*) FROM measurements GROUP BY item_name ORDER BY item_name;結果の例:
+-----------+----------+
| item_name | COUNT(*) |
+-----------+----------+
| CRP       |        2 |
| 尿蛋白    |        2 |
| 血糖      |        2 |
+-----------+----------+
3 rows in set (0.000 sec)- GROUP BY item_name:
項目名が同じ行をひとまとまりにして、まとまりごとに COUNT(*) を計算する - ORDER BY item_name:
まとめた結果の並び順を決める。日本語は読みの順ではなく文字コードの順なので、CRP → 尿蛋白 → 血糖 になる
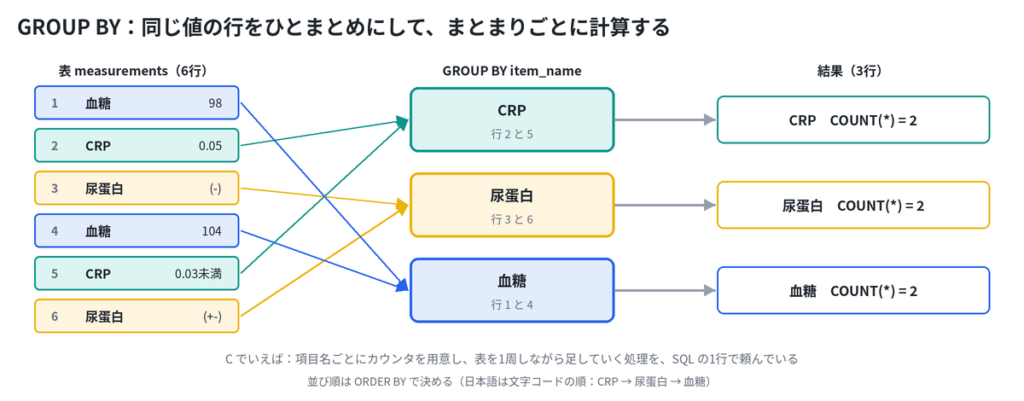
C で書くと、項目名ごとにカウンタを用意して、表を1周しながら足していく処理です。SQL では、これを1行で頼めます。
結果の見出しに名前を付ける(AS)
COUNT(*) という見出しは読みにくいので、AS で別名を付けました。
SELECT item_name AS 項目, COUNT(*) AS 件数 FROM measurements GROUP BY item_name ORDER BY item_name;結果の例:
+-----------+--------+
| 項目      | 件数   |
+-----------+--------+
| CRP       |      2 |
| 尿蛋白    |      2 |
| 血糖      |      2 |
+-----------+--------+
3 rows in set (0.000 sec)- AS 項目、AS 件数:
結果の列に別名を付ける。表の列の名前は変わらず、今回の結果の表示だけに付く
場面3:平均・最大・最小(AVG・MAX・MIN)
COUNT のように、まとまりごとに計算する関数は、ほかにもあります。項目ごとの平均・最大・最小を出しました。
SELECT item_name, AVG(value_num), MAX(value_num), MIN(value_num)
FROM measurements GROUP BY item_name ORDER BY item_name;結果の例:
+-----------+----------------+----------------+----------------+
| item_name | AVG(value_num) | MAX(value_num) | MIN(value_num) |
+-----------+----------------+----------------+----------------+
| CRP       |      0.0400000 |          0.050 |          0.030 |
| 尿蛋白    |           NULL |           NULL |           NULL |
| 血糖      |    101.0000000 |        104.000 |         98.000 |
+-----------+----------------+----------------+----------------+
3 rows in set (0.001 sec)| No. | 関数 | 意味 |
|---|---|---|
| 1 | COUNT(列) | NULL でない値の個数 |
| 2 | AVG(列) | 平均。NULL は計算に入れない |
| 3 | MAX(列) | 最大値 |
| 4 | MIN(列) | 最小値 |
| 5 | SUM(列) | 合計(今回は使っていない) |
結果の見どころは2つです。
- 平均の小数点以下が長い:
0.0400000、101.0000000 のように、平均は小数点以下の桁が増えて表示される。割り算の結果なので、データベースが桁を多めに取って計算している。値そのものは 0.04 と 101 - 尿蛋白はすべて NULL:
尿蛋白の value_num は2行とも NULL なので、計算する値が1つもない。0 にならないのは、「0 という値があった」と「値が1つもなかった」を区別するため
組み込みでいえば、センサの値を項目ごとに集計して、平均・最大・最小を出す処理です。C なら合計とカウンタ、最大値と最小値の変数を用意して、ループの中で更新していくところを、SQL ではまとめて頼めます。
場面4:絞り込んでから、まとめる
第4回の WHERE と、今回の GROUP BY を組み合わせて、「数値のある行だけを、日付ごとに数える」をやってみました。
SELECT measured_on, COUNT(*) AS 件数 FROM measurements
WHERE value_num IS NOT NULL GROUP BY measured_on ORDER BY measured_on;結果の例:
+-------------+--------+
| measured_on | 件数   |
+-------------+--------+
| 2026-09-01  |      2 |
| 2026-10-01  |      2 |
+-------------+--------+
2 rows in set (0.000 sec)どちらの日付も、3行のうち尿蛋白の1行が NULL なので除かれ、2件になりました。
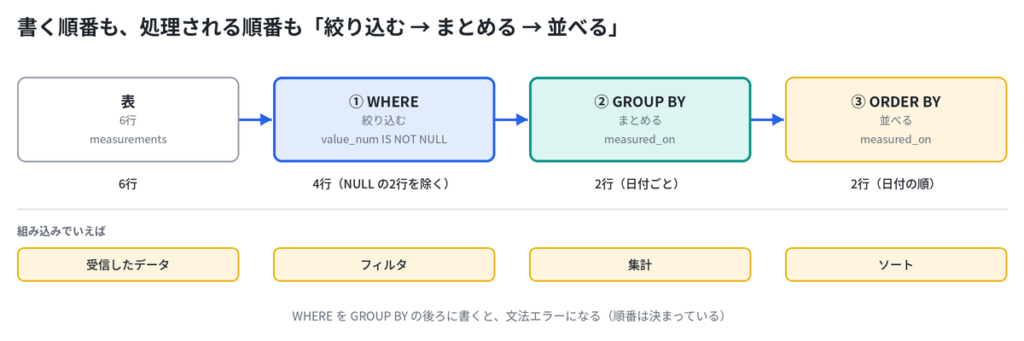
| No. | 書く順番 | 役割 | 組み込みでいうと |
|---|---|---|---|
| 1 | WHERE | 行を絞り込む | フィルタ |
| 2 | GROUP BY | 同じ値の行をまとめて計算する | 集計 |
| 3 | ORDER BY | 結果を並べる | ソート |
書く順番は決まっていて、WHERE を GROUP BY の後ろに書くと文法エラーになります。フィルタ、集計、ソートの順に処理を並べる、組み込みでおなじみのパイプラインと同じ形です。
場面5:ブログの管理で使ったコマンドを読む
旧シリーズの記事を整理したとき、「公開中の記事と、削除済み(ゴミ箱)の記事が、それぞれ何件あるか」を確かめるのに、次の形の SQL を使っていました(実際には、旧シリーズのタイトルの条件を OR でいくつか並べていました)。
SELECT post_status, COUNT(*)
FROM wp_posts
WHERE post_type = 'post' AND (post_title LIKE '%【開発記】%' OR post_title LIKE '%番外編%')
GROUP BY post_status;結果の例:
+-------------+----------+
| post_status | COUNT(*) |
+-------------+----------+
| publish     |        7 |
| trash       |       26 |
+-------------+----------+- FROM wp_posts:
WordPress の記事が入っている表から - WHERE post_type = ‘post’:
投稿だけ(固定ページなどは除く) - AND (… OR …):
タイトルが旧シリーズのどれかに当てはまるもの。OR をかっこで囲んで、AND との組み合わせをはっきりさせる - GROUP BY post_status:
記事の状態(publish = 公開中、trash = ゴミ箱 など)ごとにまとめる - SELECT post_status, COUNT(*):
状態と、その件数を表示する
練習で書いた SELECT item_name, COUNT(*) … GROUP BY item_name と、まったく同じ形です。表の名前と列の名前が違うだけです。
かっこの付け方には注意が必要です。AND は OR より先に計算されるので、かっこを付けずに post_type = ‘post’ AND A OR B と書くと、「(投稿で、かつ A)または B」という意味になり、固定ページなどの B まで数えてしまいます。C の && と || の優先順位と同じです。
まとめ
第5回では、行を数え、項目ごとにまとめて計算しました。覚えたことは、次のとおりです。
| No. | 覚えたこと | C・組み込みでいうと |
|---|---|---|
| 1 | COUNT(*) は全行、COUNT(列) は NULL でない行を数える | 全要素のカウンタと、有効な値だけのカウンタ |
| 2 | GROUP BY で、同じ値の行をまとめて計算する | 項目ごとのカウンタを、表を1周しながら足す |
| 3 | AS で、結果の見出しに別名を付ける | 表示用のラベル |
| 4 | AVG・MAX・MIN・SUM で、平均・最大・最小・合計 | 集計ループの中の合計・最大・最小の更新 |
| 5 | 値が1つもないまとまりの計算結果は NULL | 「0 があった」と「何もなかった」を区別する |
| 6 | WHERE → GROUP BY → ORDER BY の順に書く | フィルタ → 集計 → ソートのパイプライン |
ここまでの5回で、表を作り、データを入れ、取り出し、数えることができるようになりました。次回は、UPDATE と DELETE で、データを書き換えたり消したりします。失敗しても元に戻せる「トランザクション」という仕組みも、あわせて試します。
ブログの管理で使ってきたほかのコマンドは、WordPress のデータベースのコマンドを、意味から理解する記事でも紹介しています。
この記事は、シリーズ「組み込みエンジニアの Web 開発入門」の1本です。ほかの回は、シリーズの目次からどうぞ。
コメント