
前回は、表 measurements に、架空の検査値を6行入れました。2026-09-01 と 2026-10-01 の2回分で、項目は血糖・CRP・尿蛋白の3つです。
今回は、このデータを「見る・絞り込む・並べる」です。データベースの命令で、いちばんよく使うのがこの3つです。
C で、構造体の配列から条件に合うものを探すときは、for ループと if 文を書きます。
for (int i = 0; i < count; i++) {
    if (strcmp(records[i].item_name, "血糖") == 0) {   /* 絞り込む */
        printf("%s %s\n", records[i].measured_on, records[i].value_text);  /* 見る列を選ぶ */
    }
}
/* 並べるなら、先に qsort で並べ替える */SQL では、このループを自分で書かずに、「どの列を」「どの条件で」「どの順に」を書くだけで、データベースが探してくれます。
| C でやること | SQL |
|---|---|
| 表示するメンバを選ぶ | SELECT 列の名前 |
| if 文で絞り込む | WHERE 条件 |
| strstr などで文字の一部を探す | LIKE |
| qsort で並べ替える | ORDER BY |
いつものように、練習用のユーザーで入ってから打ちます。
$ mysql -u practice -p sql_practice見る列を選ぶ(SELECT)
前回は SELECT * で全部の列を見ました。* は「全部の列」という意味です。見たい列だけを、, で区切って並べることもできます。
SELECT measured_on, item_name, value_text, unit FROM measurements;結果の例:
+-------------+-----------+------------+-------+
| measured_on | item_name | value_text | unit  |
+-------------+-----------+------------+-------+
| 2026-09-01  | 血糖      | 98         | mg/dL |
| 2026-09-01  | CRP       | 0.05       | mg/dL |
| 2026-09-01  | 尿蛋白    | (-)        | NULL  |
| 2026-10-01  | 血糖      | 104        | mg/dL |
| 2026-10-01  | CRP       | 0.03未満   | mg/dL |
| 2026-10-01  | 尿蛋白    | (+-)       | NULL  |
+-------------+-----------+------------+-------+
6 rows in set (0.000 sec)- SELECT 列, 列, …:
表示する列を、表示したい順に並べる - FROM measurements:
どの表から取り出すか
id と value_num を外したので、検査の用紙に近い見え方になりました。
条件で絞り込む(WHERE)
WHERE のあとに条件を書くと、条件に合う行だけが出ます。C の if 文の中身にあたります。
日付で絞り込む
SELECT * FROM measurements WHERE measured_on = '2026-10-01';結果の例:
+----+-------------+-----------+------------+-----------+-------+
| id | measured_on | item_name | value_text | value_num | unit  |
+----+-------------+-----------+------------+-----------+-------+
|  4 | 2026-10-01  | 血糖      | 104        |   104.000 | mg/dL |
|  5 | 2026-10-01  | CRP       | 0.03未満   |     0.030 | mg/dL |
|  6 | 2026-10-01  | 尿蛋白    | (+-)       |      NULL | NULL  |
+----+-------------+-----------+------------+-----------+-------+
3 rows in set (0.000 sec)項目で絞り込む
SELECT * FROM measurements WHERE item_name = '血糖';結果の例:
+----+-------------+-----------+------------+-----------+-------+
| id | measured_on | item_name | value_text | value_num | unit  |
+----+-------------+-----------+------------+-----------+-------+
|  1 | 2026-09-01  | 血糖      | 98         |    98.000 | mg/dL |
|  4 | 2026-10-01  | 血糖      | 104        |   104.000 | mg/dL |
+----+-------------+-----------+------------+-----------+-------+
2 rows in set (0.000 sec)数値の大きさで絞り込む
SELECT * FROM measurements WHERE value_num >= 100;結果の例:
+----+-------------+-----------+------------+-----------+-------+
| id | measured_on | item_name | value_text | value_num | unit  |
+----+-------------+-----------+------------+-----------+-------+
|  4 | 2026-10-01  | 血糖      | 104        |   104.000 | mg/dL |
+----+-------------+-----------+------------+-----------+-------+
1 row in set (0.000 sec)| 書き方 | 意味 | C でいうと |
|---|---|---|
| = | 等しい | == |
| <> または != | 等しくない | != |
| >、>=、<、<= | 大きい・以上・小さい・以下 | 同じ |
C と違って、「等しい」は = を1つだけ書きます。= を2つ書く == は使いません。
値がないもの(NULL)を探す
尿蛋白の2行は、value_num が NULL(値がない)でした。これを、C のポインタの感覚で = NULL と書いて探すと、どうなるかを試しました。
SELECT * FROM measurements WHERE value_num = NULL;結果の例:
Empty set (0.000 sec)NULL の行は2行あるのに、1行も出ません(Empty set)。NULL は「値がない・分からない」という意味なので、「分からないものと等しいか」は、データベースにとって「分からない」になり、条件に合ったとは見なされないからです。
NULL を探すときは、= ではなく IS NULL を使います。
SELECT * FROM measurements WHERE value_num IS NULL;結果の例:
+----+-------------+-----------+------------+-----------+------+
| id | measured_on | item_name | value_text | value_num | unit |
+----+-------------+-----------+------------+-----------+------+
|  3 | 2026-09-01  | 尿蛋白    | (-)        |      NULL | NULL |
|  6 | 2026-10-01  | 尿蛋白    | (+-)       |      NULL | NULL |
+----+-------------+-----------+------------+-----------+------+
2 rows in set (0.000 sec)- IS NULL:
値がない行 - IS NOT NULL:
値がある行
C でいえば、ポインタが NULL かどうかを ptr == NULL で調べるのと同じ感覚で = NULL と書いてしまいますが、SQL では IS NULL と書く決まりです。
さっきの value_num >= 100 でも、NULL の尿蛋白の行は出ませんでした。NULL は「100以上か」も「分からない」になるので、大小の条件でも出てこない、と覚えておくと迷いません。
文字の一部で探す(LIKE)
「未満」が付いている結果だけを探したいときは、LIKE を使います。
SELECT * FROM measurements WHERE value_text LIKE '%未満%';結果の例:
+----+-------------+-----------+------------+-----------+-------+
| id | measured_on | item_name | value_text | value_num | unit |
+----+-------------+-----------+------------+-----------+-------+
| 5 | 2026-10-01 | CRP | 0.03未満 | 0.030 | mg/dL |
+----+-------------+-----------+------------+-----------+-------+
1 row in set (0.000 sec)SELECT * FROM measurements WHERE item_name LIKE '尿%';結果の例:
+----+-------------+-----------+------------+-----------+------+
| id | measured_on | item_name | value_text | value_num | unit |
+----+-------------+-----------+------------+-----------+------+
|  3 | 2026-09-01  | 尿蛋白    | (-)        |      NULL | NULL |
|  6 | 2026-10-01  | 尿蛋白    | (+-)       |      NULL | NULL |
+----+-------------+-----------+------------+-----------+------+
2 rows in set (0.000 sec)| 書き方 | 意味 | 例 |
|---|---|---|
| ‘%未満%’ | どこかに「未満」を含む | 0.03未満 |
| ‘尿%’ | 「尿」で始まる | 尿蛋白、尿糖 |
| ‘%値’ | 「値」で終わる | 基準値 |
% は「どんな文字が何文字あってもよい(0文字でもよい)」という印です。C でいえば、strstr で文字列の中を探すのに近い動きです。前回の「0.03未満」のように、元の意味を value_text に残しておいたおかげで、こうして探せます。
並べる(ORDER BY)
ORDER BY のあとに列の名前を書くと、その列の順に並べ替えます。C で qsort に比較関数を渡して並べ替えるところを、1行で頼めます。
数値の大きい順に並べる
SELECT measured_on, item_name, value_num FROM measurements ORDER BY value_num DESC;結果の例:
+-------------+-----------+-----------+
| measured_on | item_name | value_num |
+-------------+-----------+-----------+
| 2026-10-01  | 血糖      |   104.000 |
| 2026-09-01  | 血糖      |    98.000 |
| 2026-09-01  | CRP       |     0.050 |
| 2026-10-01  | CRP       |     0.030 |
| 2026-09-01  | 尿蛋白    |      NULL |
| 2026-10-01  | 尿蛋白    |      NULL |
+-------------+-----------+-----------+
6 rows in set (0.000 sec)- ORDER BY 列:
その列の小さい順(ASC)に並べる。ASC は書かなくてもよい - DESC:
大きい順に並べる
NULL の行は、一番最後に並びました。MariaDB では、NULL は「どの値よりも小さい」として扱われるので、小さい順(ASC)なら最初に、大きい順(DESC)なら最後に来ます。
2つの列で並べる
日付の新しい順に並べて、同じ日付の中は項目名の順にします。
SELECT measured_on, item_name, value_text FROM measurements ORDER BY measured_on DESC, item_name;結果の例:
+-------------+-----------+------------+
| measured_on | item_name | value_text |
+-------------+-----------+------------+
| 2026-10-01  | CRP       | 0.03未満   |
| 2026-10-01  | 尿蛋白    | (+-)       |
| 2026-10-01  | 血糖      | 104        |
| 2026-09-01  | CRP       | 0.05       |
| 2026-09-01  | 尿蛋白    | (-)        |
| 2026-09-01  | 血糖      | 98         |
+-------------+-----------+------------+
6 rows in set (0.000 sec), で区切ると、1つ目の列で並べたあと、同じ値の中を2つ目の列で並べます。
ここで気づいたのが、項目名の並び順です。読みで並べるなら「CRP(シーアールピー)・血糖(けっとう)・尿蛋白(にょうたんぱく)」になりそうですが、結果は「CRP・尿蛋白・血糖」でした。漢字は、読みではなく、文字ごとに決まった番号(文字コード)の順に並ぶためです。日本語の項目を読みの順に並べたいときは、読みがなの列を別に持つなどの工夫がいります。
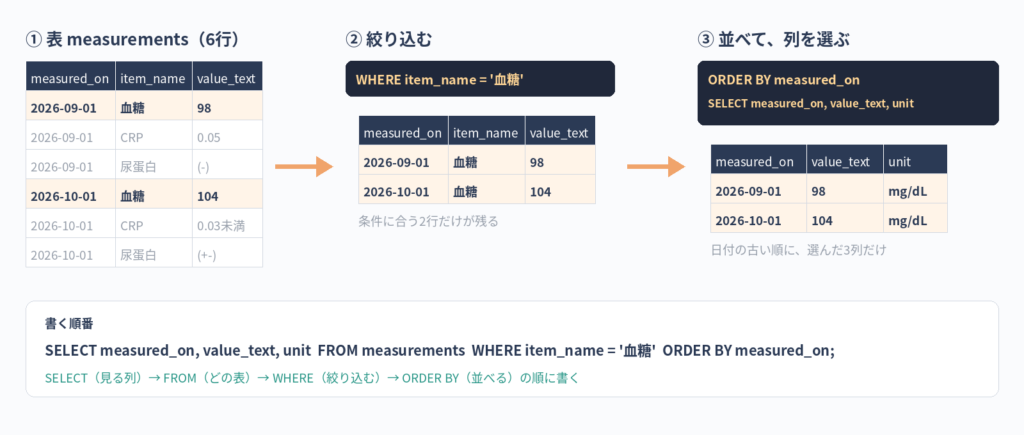
絞り込んで、並べる
WHERE と ORDER BY は、組み合わせて使えます。血糖だけを、日付の古い順に見ます。
SELECT measured_on, value_text, unit FROM measurements WHERE item_name = '血糖' ORDER BY measured_on;結果の例:
+-------------+------------+-------+
| measured_on | value_text | unit  |
+-------------+------------+-------+
| 2026-09-01  | 98         | mg/dL |
| 2026-10-01  | 104        | mg/dL |
+-------------+------------+-------+
2 rows in set (0.000 sec)書く順番は、SELECT → FROM → WHERE → ORDER BY と決まっています。この順番を入れ替えるとエラーになります。この先の血液検査アプリでも、「ある項目の値を、日付の順に並べてグラフにする」ときに、この形をそのまま使います。
まとめと次回予告
| この回で覚えたこと | C でいうと |
|---|---|
| SELECT 列, 列 で見る列を選ぶ(* は全部) | 表示するメンバを選ぶ |
| WHERE 条件 で絞り込む。等しいは = | for ループの中の if 文 |
| NULL は = ではなく IS NULL で探す | ポインタの NULL チェック(ただし書き方が違う) |
| LIKE ‘%文字%’ で文字の一部を探す | strstr |
| ORDER BY 列 DESC で並べる。NULL は一番小さい扱い | qsort と比較関数 |
| 日本語は読みではなく、文字コードの順に並ぶ | 文字コードの大小で比べる strcmp |
| SELECT → FROM → WHERE → ORDER BY の順に書く | 決まった書式のコマンドフレーム |
次回は「数える・まとめる」です。COUNT で行の数を数えたり、GROUP BY で項目ごとにまとめたりします。
→ データベース編 第5回:数える・まとめる
この記事は、シリーズ「組み込みエンジニアの Web 開発入門」の1本です。ほかの回は、シリーズの目次からどうぞ。


コメント