前回(第3回)は複数のExcelファイルを同時に読み込み、画面にリスト表示するところまで実装した。 しかし、ここで一つの大きな問題に直面する。医療機関や受診した年によって、「Excelのフォーマット(表の開始位置や列の順番)」が微妙に異なるのだ。
1行目からいきなりデータが始まることもあれば、上部に病院名や受診日が書かれていて5行目から表が始まることもある。
「2列目が結果」と決め打ちでプログラムを書いてしまうと、フォーマットが変わった瞬間にエラーになってしまう。
そこで今回は、読み込んだExcelの生データの中から「検査項目」「結果」「単位」と書かれたヘッダー(見出し)行をプログラムに自力で探させ、動的にデータを抽出する賢いロジックを実装していく。
1. ヘッダー行を動的に見つける処理
まずは、読み込んだ二次元配列(行と列のデータ)の中から、「表の見出し」にあたる行を探す。
「検査項目」または「項目名」という文字列が含まれている行を見つけるための関数 extractBloodTestData を作成する。
// 生データから必要な列を抽出・整形する関数
  const extractBloodTestData = (rawData: any[][]): BloodTestRecord[] => {
    // 1. "検査項目" または "項目名" という文字が含まれる行(ヘッダー行)を探す
    const headerRowIndex = rawData.findIndex(row =>
      row.includes("検査項目") || row.includes("項目名")
    );

    // ヘッダーが見つからなければ、対象のデータがないとみなして空配列を返す
    if (headerRowIndex === -1) return [];

    const headerRow = rawData[headerRowIndex];

// ...(次に続く)2. 必要なデータの列番号(インデックス)を特定する
見出しの行が見つかったら、次はその行の中で「検査項目」「結果」「単位」がそれぞれ左から何番目の列にあるかを特定する。これで列の順番が入れ替わっても正しくデータを取得できる。
// ...(先ほどの続き)
    // 2. 必要な情報が何列目にあるかを特定する
    const nameIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && (cell.includes("検査項目") || cell.includes("項目名")));
    const valueIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && cell.includes("結果"));
    const unitIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && cell.includes("単位"));

    const records: BloodTestRecord[] = [];

// ...(次に続く)3. データをループしてJSON(扱いやすい形式)に整形する
表の開始位置(headerRowIndex)と、各データが何列目にあるかが分かったので、見出し行の「次の行」から最後までループを回し、必要なデータだけを抜き出して綺麗な配列に詰め直す。
// ...(先ほどの続き)
    // 3. ヘッダー行の次の行から最後までループを回してデータを抽出
    for (let i = headerRowIndex + 1; i < rawData.length; i++) {
      const row = rawData[i];
      // 行自体が空、または項目名が空欄の場合はスキップ
      if (!row || !row[nameIndex]) continue;

      records.push({
        itemName: String(row[nameIndex]).trim(),
        // 結果が空欄の場合は空文字を入れる
        value: row[valueIndex] !== undefined ? row[valueIndex] : '',
        unit: row[unitIndex] || '',
      });
    }

    return records;
};4. ファイル読み込み処理への組み込み
作成した extractBloodTestData 関数を、前回作ったファイル読み込み処理(handleFileUpload)の中で呼び出すように変更する。 生データを直接Stateに入れるのではなく、この関数を通して「濾過(ろか)」した綺麗なデータだけを保存する。
【変更箇所】
// Excelの中身を生の二次元配列として取得
        const rawData = XLSX.utils.sheet_to_json<any[]>(worksheet, { header: 1 });

        // ★作成した抽出関数を通して、必要なデータだけを綺麗な形で取得する
        const formattedRecords = extractBloodTestData(rawData);

        const dateLabel = file.name.replace('.xlsx', '').replace('.xls', '');

        // 抽出された綺麗なデータをStateに追加
setUploadedFiles(prev => [...prev, { fileName: dateLabel, records: formattedRecords }]);5. 完成したコード全体(App.tsx)
ここまでの改修を反映した、第4回時点での App.tsx の全体コードがこちらだ。(※本格的なコンポーネント分割は後半で行うため、引き続き単一ファイルで進める)
// src/App.tsx
import React, { useState } from 'react';
import * as XLSX from 'xlsx';

// データの型定義
export interface BloodTestRecord {
  itemName: string;
  value: number | string;
  unit: string;
}

export interface UploadedFile {
  fileName: string;
  records: BloodTestRecord[];
}

export default function App() {
  const [uploadedFiles, setUploadedFiles] = useState<UploadedFile[]>([]);

  // 生データから動的に検査項目・結果・単位を抽出する関数
  const extractBloodTestData = (rawData: any[][]): BloodTestRecord[] => {
    // 1. ヘッダー行を探す
    const headerRowIndex = rawData.findIndex(row => row.includes("検査項目") || row.includes("項目名"));
    if (headerRowIndex === -1) return [];

    const headerRow = rawData[headerRowIndex];

    // 2. 各データが何列目にあるか特定する
    const nameIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && (cell.includes("検査項目") || cell.includes("項目名")));
    const valueIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && cell.includes("結果"));
    const unitIndex = headerRow.findIndex((cell: any) => typeof cell === 'string' && cell.includes("単位"));

    const records: BloodTestRecord[] = [];

    // 3. ループで抽出して整形
    for (let i = headerRowIndex + 1; i < rawData.length; i++) {
      const row = rawData[i];
      if (!row || !row[nameIndex]) continue;

      records.push({
        itemName: String(row[nameIndex]).trim(),
        value: row[valueIndex] !== undefined ? row[valueIndex] : '',
        unit: row[unitIndex] || '',
      });
    }
    return records;
  };

  // 複数ファイルの読み込み処理
  const handleFileUpload = (e: React.ChangeEvent<HTMLInputElement>) => {
    const files = e.target.files;
    if (!files || files.length === 0) return;

    Array.from(files).forEach(file => {
      const reader = new FileReader();
      reader.onload = (event) => {
        const bstr = event.target?.result;
        const workbook = XLSX.read(bstr, { type: 'binary' });
        const worksheet = workbook.Sheets[workbook.SheetNames[0]];
        const rawData = XLSX.utils.sheet_to_json<any[]>(worksheet, { header: 1 });

        // ★抽出関数でデータを濾過
        const formattedRecords = extractBloodTestData(rawData);
        const dateLabel = file.name.replace('.xlsx', '').replace('.xls', '');

        setUploadedFiles(prev => [...prev, { fileName: dateLabel, records: formattedRecords }]);
      };
      reader.readAsBinaryString(file);
    });

    e.target.value = '';
  };

  return (
    <div style={{ padding: '20px', fontFamily: 'sans-serif', maxWidth: '800px', margin: '0 auto' }}>
      <h1>血液検査記録アプリ(プロトタイプ)</h1>

      <div style={{ marginBottom: '20px', padding: '20px', backgroundColor: '#f0f4f8', borderRadius: '8px' }}>
        <p style={{ marginTop: 0, fontWeight: 'bold' }}>Excelファイルを選択(複数選択可):</p>
        <input type="file" accept=".xlsx, .xls" multiple onChange={handleFileUpload} />
      </div>

      {/* 抽出されたデータを一覧表示 */}
      {uploadedFiles.map((fileInfo, index) => (
        <div key={index} style={{ marginBottom: '20px', border: '1px solid #ccc', padding: '10px', borderRadius: '4px' }}>
          <h3>📅 {fileInfo.fileName}</h3>
          <p>抽出完了: {fileInfo.records.length}項目</p>
          <ul style={{ maxHeight: '150px', overflowY: 'auto', backgroundColor: '#f9f9f9', padding: '10px' }}>
            {fileInfo.records.map((record, rIndex) => (
              <li key={rIndex}>
                <strong>{record.itemName}</strong>: {record.value} {record.unit}
              </li>
            ))}
          </ul>
        </div>
      ))}
    </div>
  );
}ブラウザで再読み込みしてExcelをアップロードしてみる。フォーマットが異なる過去のファイルを入れても、プログラムが自動で「見出し」を探し出し、必要な項目だけを綺麗に抽出してくれるはずだ。
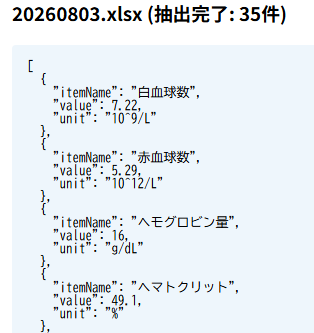
データが整ったことで、次回(第5回)は画面上にテーブル(表)を作成し、抽出した数値を画面上で直接微調整したり、不要な項目を削除したりできる機能を作っていく。が間違っていた場合に備えてブラウザ上で数値を直接微調整・削除できるテーブルUIを作成していく。



コメント